冰封行星技术笔记 · 第 2 轨道
蓝巨星 B0 Ia · 轨道半径 12.3 万 km · 行星环
AlphaZero 风格棋类强化学习框架
一个基于 Python、PyTorch、MCTS 和自博弈训练流程的 AlphaZero 风格棋类 AI 实验框架
- 发布
- 字数
- 1,449
- 阅读
- 4 分钟
AlphaZero 最吸引人的地方,不只是它能下棋,而是它给出了一种很通用的思路:只要一个游戏可以被表示成状态、动作、合法走法和胜负结果,就有机会通过自博弈、蒙特卡洛树搜索和神经网络不断改进策略。这个项目就是围绕这个想法整理出来的一个现代化实验框架,目标不是复刻官方 AlphaZero,而是提供一个更容易运行、扩展和理解的棋类强化学习工程骨架。
项目背景
这个仓库是基于经典开源项目 suragnair/alpha-zero-general 的现代化重构版本。原项目已经很好地抽象出了 Game、NeuralNet、MCTS、Coach 和 Arena 这些核心概念,但早期代码同时包含 Keras、TensorFlow、PyTorch 等多套实现方式,工程入口也比较分散。重构后的版本把主要运行路径统一到 Python 3.11+ 和 PyTorch 上,并整理为标准的 src/ 包结构。
当前项目提供统一的 alphazero 命令行入口,支持列出游戏、训练模型、对战评估、运行 smoke test,也提供可选的 Gradio 图形界面。内置游戏包括 Othello、Tic-Tac-Toe、3D Tic-Tac-Toe、Connect Four、GoBang、Tafl、RTS、Dots and Boxes 和 Santorini,其中大部分游戏都带有 PyTorch 神经网络包装器。
整体架构
项目的核心结构可以理解为五层:
- Game:定义棋盘、动作空间、合法走法、胜负判断、对称变换和状态编码
- MCTS:根据神经网络给出的策略先验和价值估计进行搜索
- NeuralNet:用 PyTorch 模型学习策略分布和局面价值
- Coach:负责自博弈、训练样本收集、模型训练和新旧模型比较
- Arena:让两个玩家或两个模型进行多局对战,评估新模型是否真的更强
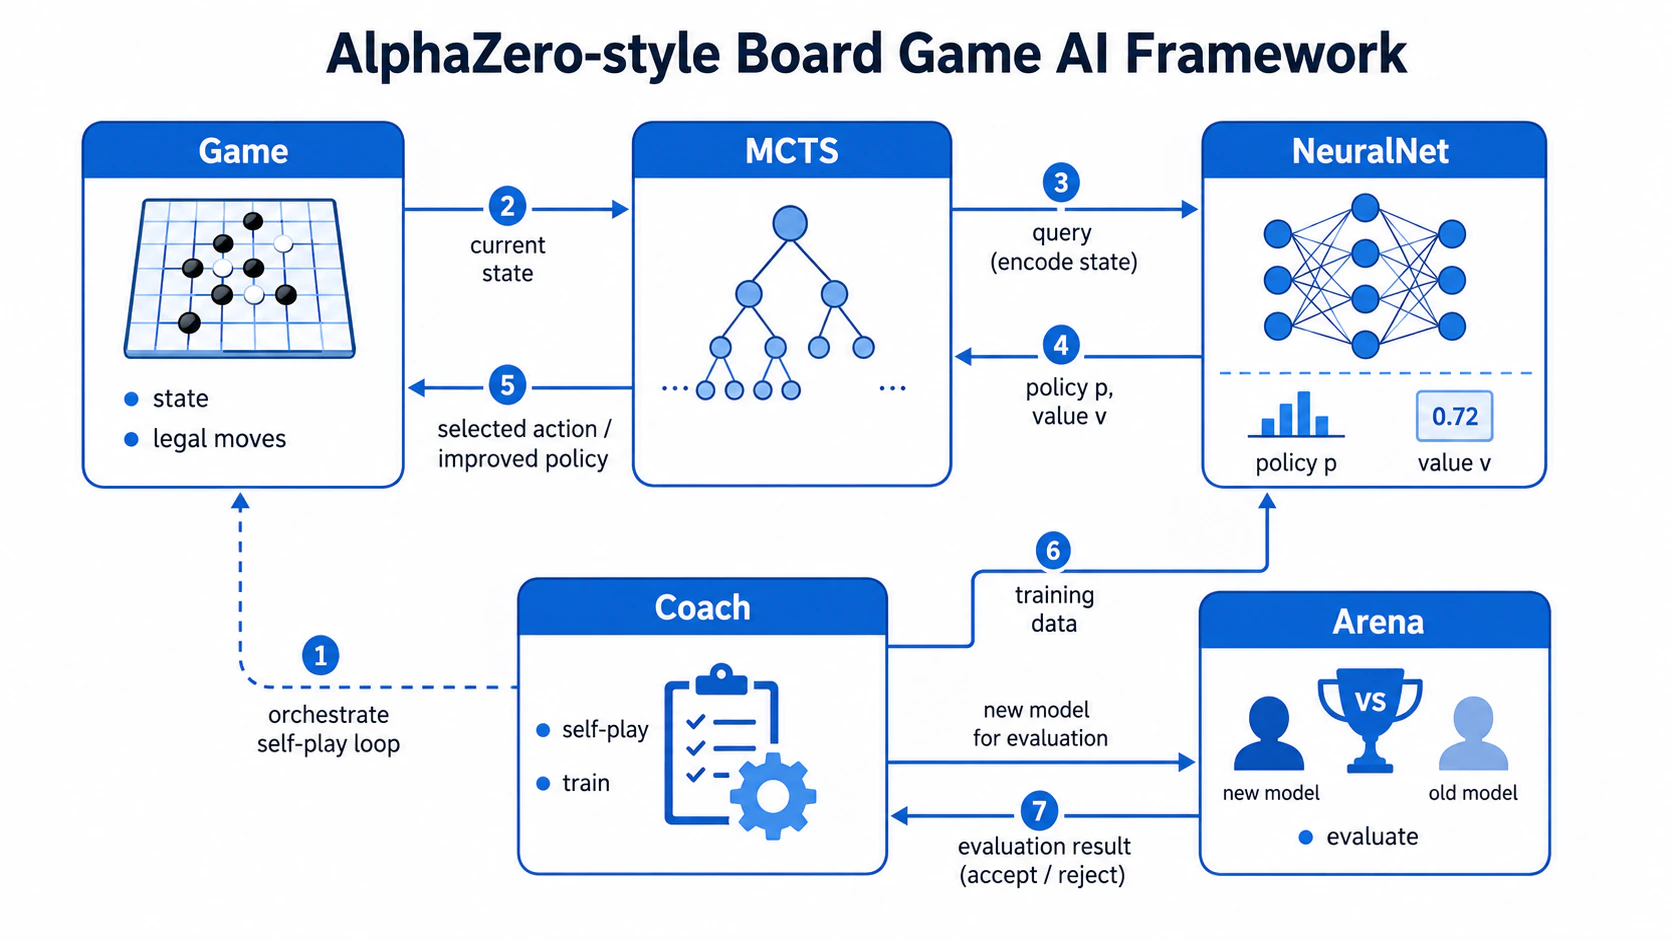 AlphaZero 框架架构图
核心算法:MCTS + 神经网络
传统搜索算法通常依赖人工设计的局面评估函数,而 AlphaZero 风格方法把这部分交给神经网络。网络输入当前棋盘,输出两个结果:一个是每个动作的概率分布,另一个是当前局面对当前玩家的价值估计。MCTS 在搜索时利用这两个结果,既探索可能的好走法,也逐渐把搜索集中到更有希望的分支上。
项目里的 MCTS 使用的是 PUCT 风格选择公式,可以简化理解为:
其中 表示动作的平均价值, 是神经网络给出的策略先验, 和 是访问次数, 控制探索强度。这样每一步并不是直接相信神经网络,而是用搜索对网络判断进行修正。
训练流程
训练由 Coach 驱动,整体过程非常清晰:
- 从初始棋盘开始,让当前模型通过 MCTS 和自己对弈
- 记录每一步的规范化棋盘、MCTS 产生的策略分布和最终胜负结果
- 利用棋盘对称性扩充训练样本
- 用这些样本训练新的神经网络
- 让新模型和旧模型在 Arena 中对战
- 如果新模型胜率超过阈值,就保存为新的最佳模型
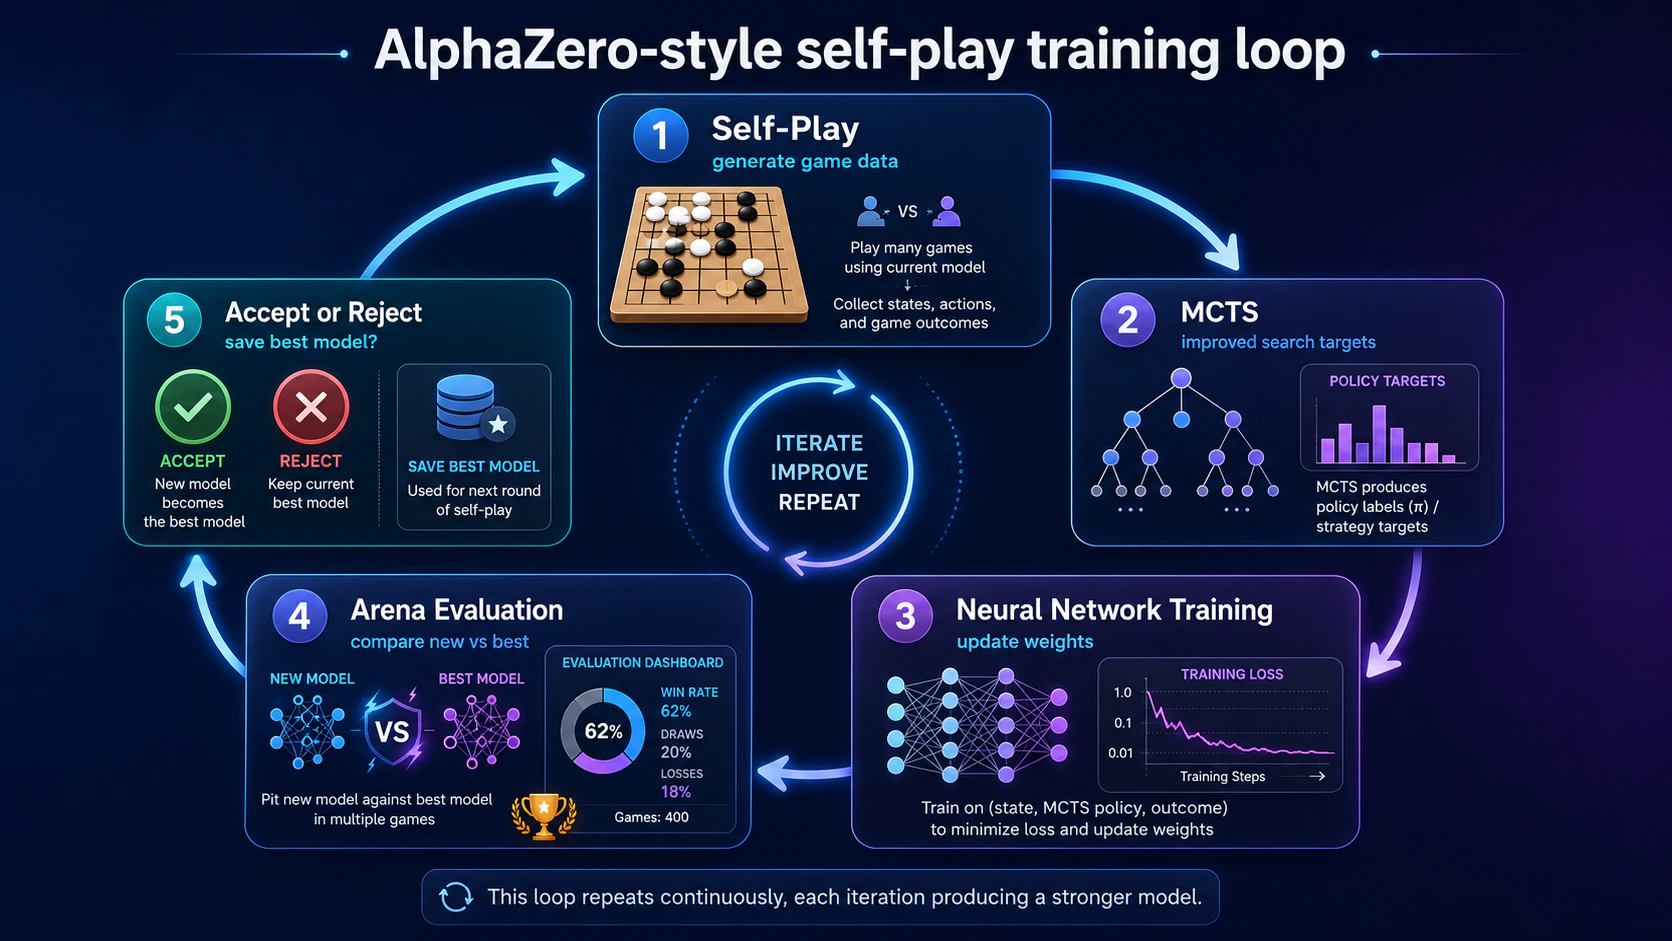 自博弈训练流程图
这个流程的关键点在于:模型不是靠人类棋谱学习,而是通过自己生成经验、自己训练、自己评估来迭代。虽然小规模实验无法达到真正 AlphaZero 的算力水平,但用来理解自博弈强化学习的工程闭环已经足够直观。
命令行使用
项目安装后可以直接使用 alphazero 命令。比如查看所有已注册游戏:
alphazero list运行一个很小的测试训练任务:
alphazero train --game othello --board-size 6 --iters 2 --episodes 2 --sims 10也可以让不同玩家进行对战,例如随机玩家和贪心玩家:
alphazero pit --game othello --board-size 6 --p1 random --p2 greedy --games 4图形界面
除了命令行,项目还提供了一个可选的 Gradio GUI。它主要对应 pit 对战功能,可以选择游戏、棋盘大小、玩家类型、神经网络 checkpoint、MCTS 模拟次数和 c_puct 参数。对于展示 AI 对战或手动体验棋类规则来说,比纯命令行更直观。
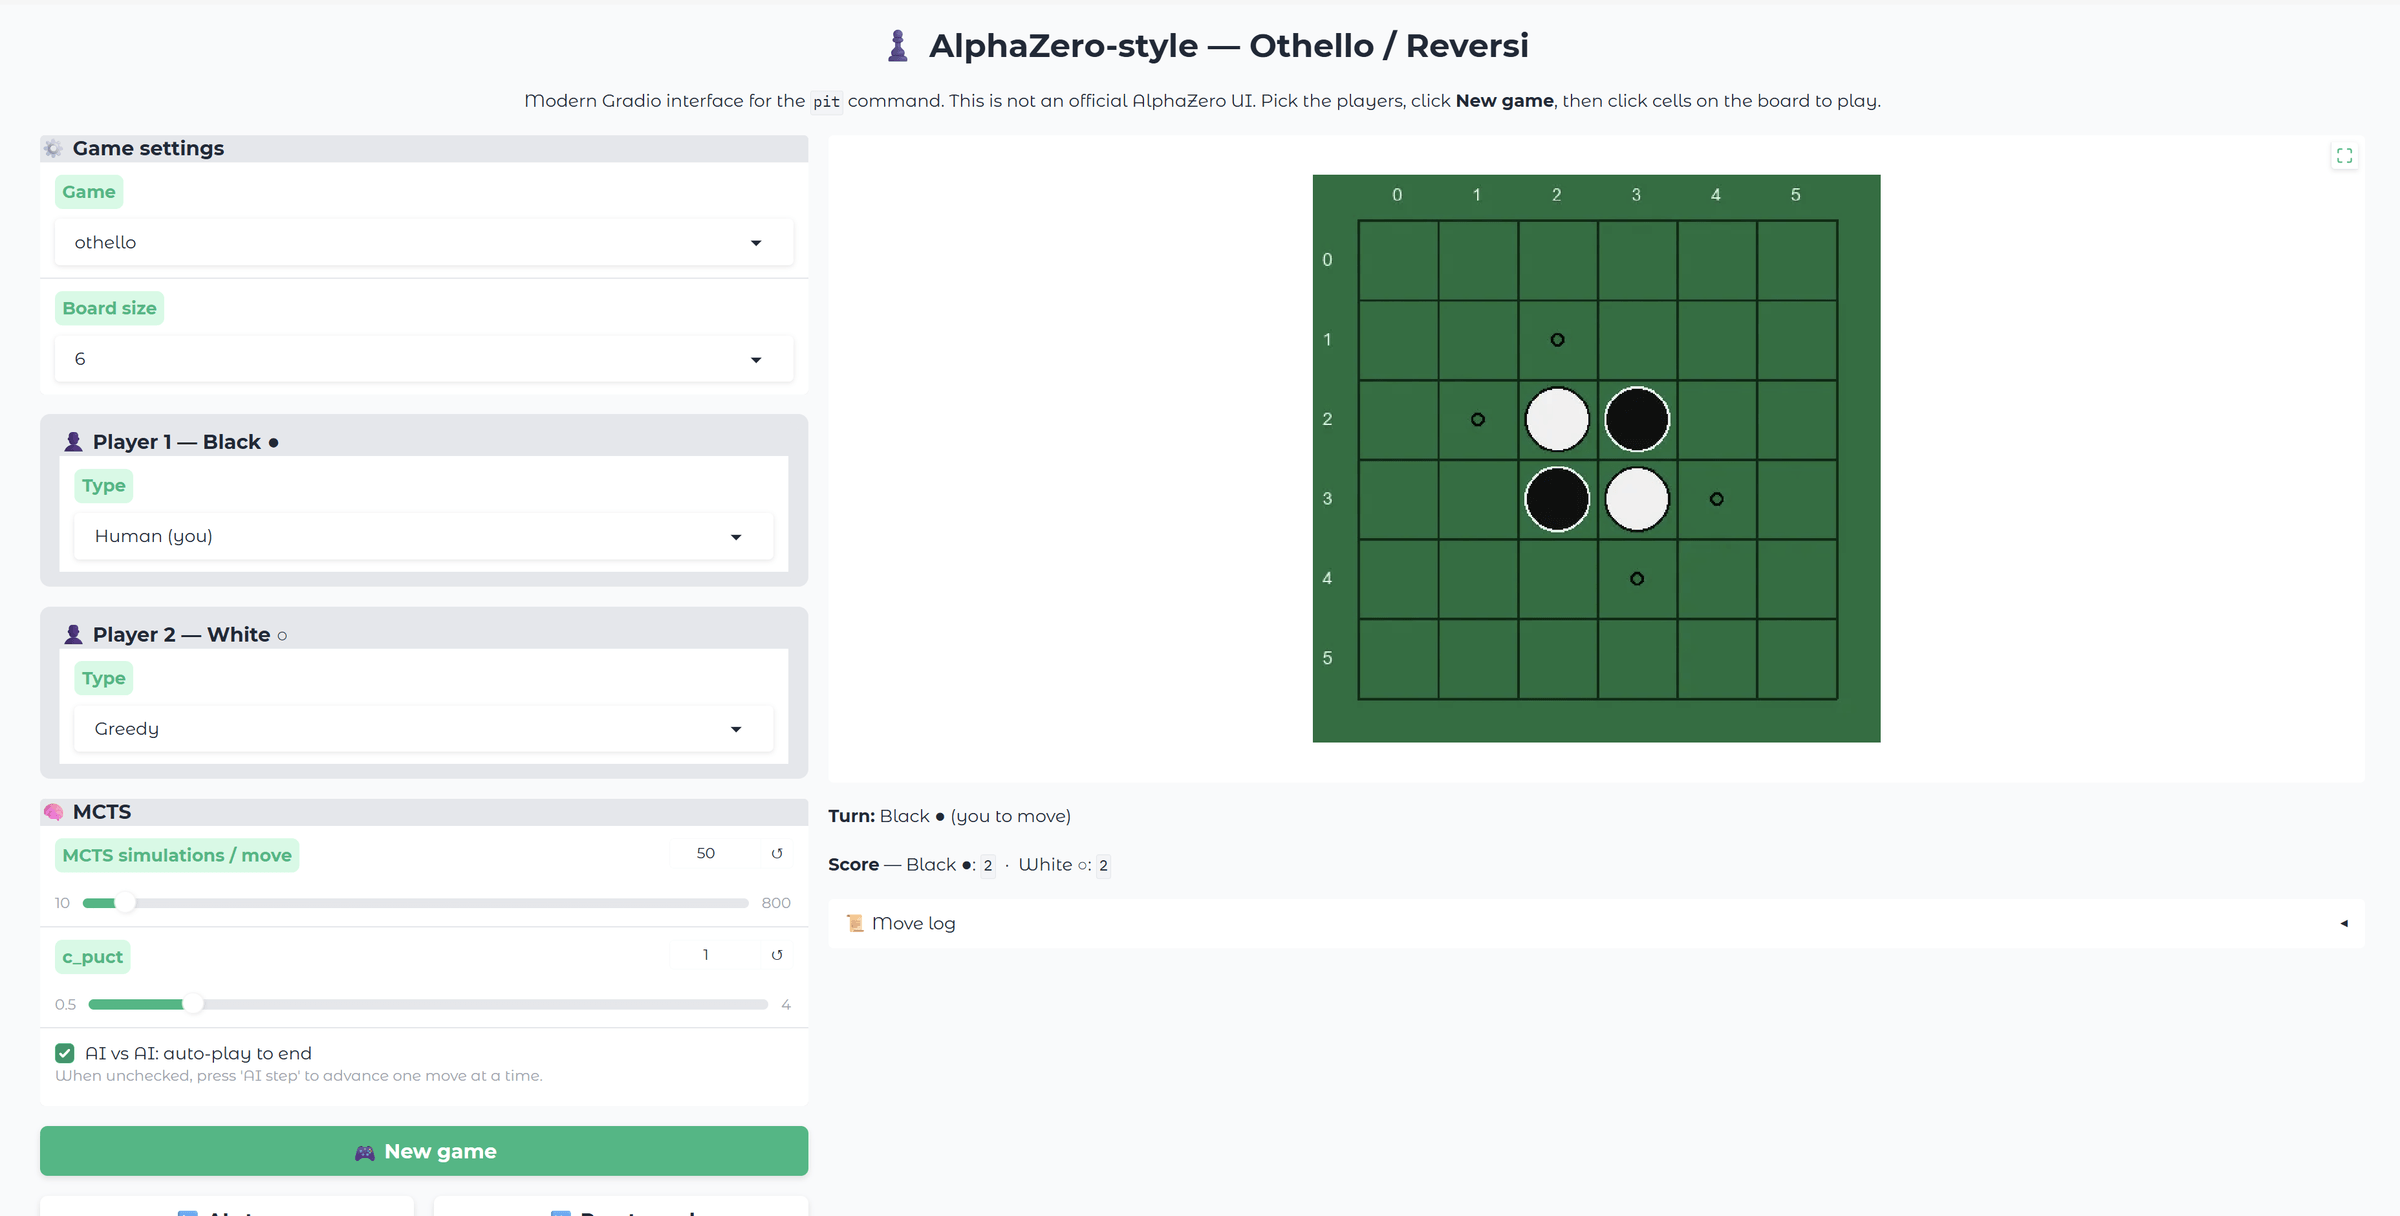 Gradio 图形界面截图
启动方式如下:
pip install -e ".[gui]"
alphazero gui工程重构重点
这次整理不仅是把代码跑起来,也尽量让项目更适合作为后续实验基础。主要改动包括:
- 统一为
src/alphazero/包结构,便于安装、导入和测试 - 提供统一 CLI,避免每个游戏维护一套零散脚本
- 保留核心抽象,让新增棋类只需要实现 Game 接口和可选的 NNetWrapper
- 统一 PyTorch 训练路径,减少框架混用带来的维护成本
- 补充 Docker、测试、lint、类型检查和第三方许可证说明
- 明确上游来源和 MIT License 归属,避免把它误认为官方 AlphaZero 实现
本地运行
如果想在本地复现实验,可以按下面方式安装:
git clone https://github.com/2023Heng/alphazero-style-board-games-framework.git
cd alphazero-style-board-games-framework
python -m venv .venv
.\.venv\Scripts\Activate.ps1
python -m pip install -U pip
pip install -r requirements.txt
pip install -e .
可选功能可以通过 extras 安装:
pip install -e ".[dev,gui,server,rts,notebook]"代码链接
项目源码已经整理为独立仓库,可以直接查看、安装和运行: